
고객지원
뉴스룸
| 카테고리 | 사내소식 |
| 제목 | 모빌린트 MLA100 NPU 테스트 진행 |
| 작성일자 | 2026-03-23 |
|
엑세스랩 Arm 서버에서 모빌린트 MLA100 NPU 테스트 진행
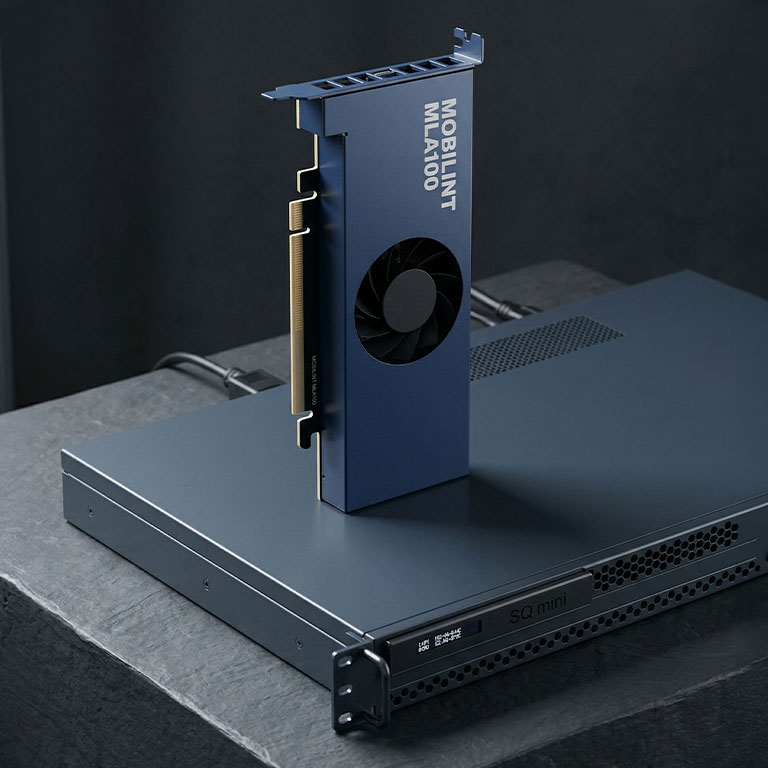
엑세스랩은 자사의 초소형 엣지 Arm 서버인 V-Raptor SQ mini에 국산 NPU 개발업체 모빌린트의 고성능 NPU인 MLA100을 장착하여 연산 성능과 시스템 안정성을 측정하는 기술 검증(PoC) 테스트를 진행했다.
이번 테스트는 SQ mini에 PCIe Gen 2 x1 인터페이스 기반 확장 카드를 장착한 환경에서 AI 추론 장치와 네트워크 장치가 얼마나 안정적으로 협업할 수 있는지 확인하는 데 중점을 두었다.
PCIe Gen 2 x1 확장 카드에서의 LLM 구동 검증
이번 검증의 핵심은 확장 카드의 PCIe Gen2 x1 슬롯이라는 물리적 제약 아래서 MLA100 NPU의 실질적인 성능을 측정하는 것이었다.
엑세스랩은 Llama-3.2-3B-Instruct 모델을 활용해 성능을 분석했다.
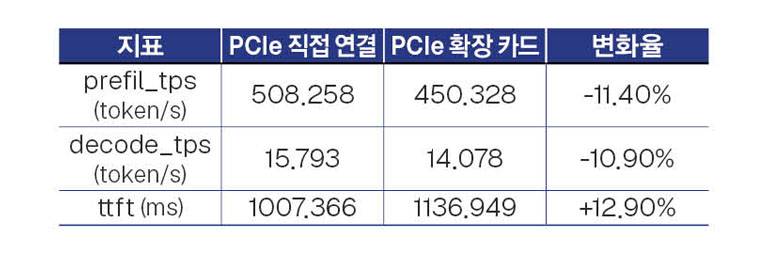
테스트 결과, PCIe 확장 카드를 장착했을 때와 그렇지 않았을 때의 성능 차이는 약 11% 수준으로 억제되었다. 상세 지표는 다음과 같다.
데이터 전송 대역폭이 좁은 x1 슬롯임에도 불구하고, 실제 추론 속도인 decode 성능은 안정적인 수치를 유지했다. 이는 SQ mini의 시스템 설계가 NPU의 연산 능력을 뒷받침할 만큼 효율적임을 보여준다.
Global 8 Mode의 유연성
모빌린트 MLA100에 탑재된 Aries 칩은 본래 8개의 코어를 가진 아키텍처로, 원활한 구동을 위해 PCIe x8 인터페이스를 권장한다. 하지만 엑세스랩은 이번 테스트에서 소프트웨어적인 제어(qbruntime)를 통해 8개 코어 전체에 워크로드를 분산하는 Global 8 Mode를 구현했다.
물리적인 레인(Lane) 수가 단 1개뿐인 극한의 환경에서도 8개 코어 모두에 연산 자원을 100% 할당할 수 있음을 입증했다.
엑세스랩은 이를 통해 하드웨어 구성의 유연성을 확보함과 동시에, NPU의 가용성 문제를 소프트웨어적으로 해결할 수 있다는 기술적 가능성을 제시했다.
대용량 네트워크 전송과 AI 추론의 병행 안정성
엑세스랩은 AI 성능 측정에 그치지 않고, 실제 서비스 환경을 가정한 복합 부하 테스트도 실시했다.
NPU와 10G NIC(네트워크 카드)가 동일한 PCIe 버스 자원을 공유하며 동시에 구동되는 환경을 구축했다.
먼저 iperf3를 이용한 루프백 테스트 결과, 약 4.80 Gbps의 실측 대역폭을 확보했다. 이는 PCIe Gen2 x1의 이론상 물리 한계치인 5Gbps를 감안하면 사실상 최상의 라인 레이트다.
또한 NPU를 통한 AI 추론 작업과 NIC를 통한 대용량 데이터 전송을 동시에 수행했을 때, NPU 단독 구동 시와 비교하여 성능 저하 폭은 1% 내외에 불과했다.
이러한 결과는 SQ mini 내부의 PCIe 버스 자원 관리 능력이 탁월함을 시사하고 있다. 고부하 작업이 병행되는 상황에서도 시스템 프리징이나 연산 오류, 커널 패닉 없이 각 장치가 독립적으로 안정성을 유지했다.
엣지 AI 인프라의 새로운 대안
엑세스랩의 SQ mini는 이번 검증을 통해 모빌린트 MLA100과 같은 고성능 NPU를 탑재한 에지 AI 서버로서의 충분한 역량을 갖추었음을 확인했다.
특히 공간적 제약이 큰 환경에서도 고성능 AI 추론과 네트워크 처리를 동시에 실현할 수 있다는 점이 고무적이다.
엑세스랩 관계자는 『이번 테스트 결과는 초소형 폼팩터 서버에서도 하이엔드 NPU를 활용한 AI 서비스 구축이 가능함을 보여주는 중요한 이정표』라며, 『앞으로도 국산 NPU 생태계와의 긴밀한 협력을 통해 최적의 엣지 AI 인프라 솔루션을 제공하겠다』고 밝혔다.
|
|
| 첨부파일 | |
| 조회수 | 962 |
| 다운로드수 | 0 |


|
